กลยุทธ์ตั้งค่า Hot Spare สำหรับสตอเรจและเซิร์ฟเวอร์: หลักการทำงาน ป้องกันข้อมูลสูญหาย และการปลดระวางไดรฟ์อย่างปลอดภัย
ทำความเข้าใจระบบ Hot Spare ใน Storage และ RAID ว่าทำงานอย่างไรเพื่อทดแทนไดรฟ์ที่ชำรุดทันที พร้อมแนวทางตั้งค่า Dedicated vs Global Spare และการจัดการทำลายข้อมูลฮาร์ดดิสก์เมื่อไดรฟ์หมดสภาพตามมาตรฐานความปลอดภัย
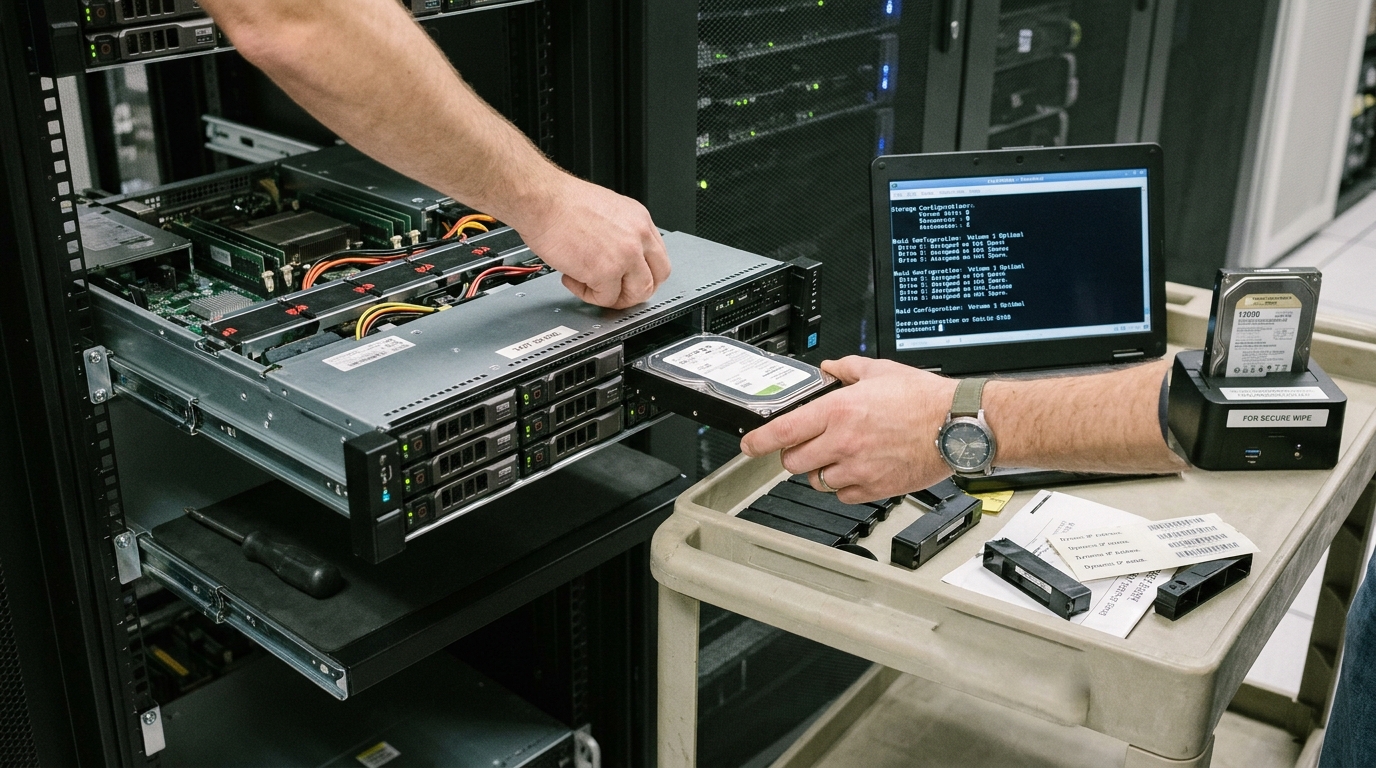
Hot Spare คืออะไร และช่วยลดความเสี่ยงข้อมูลสูญหายในระบบสตอเรจได้อย่างไร
Hot Spare คือฮาร์ดดิสก์ (HDD) หรือโซลิดสเตตไดรฟ์ (SSD) สำรองที่ติดตั้งสแตนด์บายไว้ในระบบเซิร์ฟเวอร์หรือสตอเรจคอนโทรลเลอร์ (Storage Array / SAN / NAS) โดยระบบจะเปิดการทำงานของอุปกรณ์นี้ไว้ แต่ยังไม่มีการเขียนหรืออ่านข้อมูลในสภาวะปกติ หน้าที่หลักของ Hot Spare คือการเข้ามารับหน้าที่แทนไดรฟ์สมาชิกหลักในกลุ่ม RAID ทันทีที่ระบบตรวจพบว่าไดรฟ์ตัวใดตัวหนึ่งเสียหายอย่างสิ้นเชิง (Failed) หรือเริ่มมีค่าความผิดปกติเกินเกณฑ์ที่ระบบกำหนด
หัวใจสำคัญที่ทำให้ Hot Spare มีความสำคัญอย่างยิ่งต่อผู้ดูแลระบบและฝ่ายไอที คือการลดระยะเวลาที่ระบบตกอยู่ในสภาวะเสี่ยง (Window of Vulnerability) ในสถาปัตยกรรม RAID เช่น RAID 5 หรือ RAID 6 เมื่อไดรฟ์ตัวหนึ่งพัง อาร์เรย์จะเข้าสู่สถานะ Degradation ซึ่งหากไม่มีระบบ Hot Spare ระบบจะต้องรอให้ผู้ดูแลเดินทางเข้ามาถอดเปลี่ยนไดรฟ์จริงด้วยตนเอง ช่วงเวลารอคอยดังกล่าวอาจกินเวลานานหลายชั่วโมงหรือหลายวัน หากไดรฟ์อีกตัวพังซ้ำในระหว่างนี้ ข้อมูลทั้งหมดในชุด RAID 5 อาจสูญหายอย่างถาวรทันที
การมี Hot Spare จะทำให้กระบวนการสร้างข้อมูลขึ้นมาใหม่ (Rebuild) เริ่มต้นขึ้นในระดับวินาทีหลังจากตรวจพบความล้มเหลว ทำให้ความสมบูรณ์ของโครงสร้างข้อมูล (Fault Tolerance) ฟื้นฟูกลับมาเร็วที่สุด ลดภาระงานฉุกเฉินนอกเวลาของฝ่ายระบบ และช่วยให้ระบบงานสำคัญทำงานได้อย่างต่อเนื่องโดยไม่ต้องหยุดให้บริการ
ความแตกต่างระหว่าง Hot Spare, Cold Spare และ Warm Spare
เพื่อให้วางแผนการบริหารจัดการอุปกรณ์จัดเก็บข้อมูลได้อย่างคุ้มค่าและปลอดภัย ผู้ดูแลระบบจำเป็นต้องแยกแยะสถานะของไดรฟ์สำรองแต่ละประเภทอย่างชัดเจน:
- Hot Spare: ไดรฟ์ที่เสียบอยู่ในช่องเบย์ของเซิร์ฟเวอร์หรือสตอเรจตลอดเวลา ได้รับการจ่ายพลังงานและเชื่อมต่อเข้ากับ RAID Controller หรือ Storage OS ไว้ล่วงหน้า เมื่อเกิดข้อผิดพลาด คอนโทรลเลอร์สามารถสั่ง Rebuild เข้ามาที่ไดรฟ์นี้ได้ทันทีโดยอัตโนมัติ 100% โดยไม่ต้องมีการสัมผัสเครื่องจริง
- Warm Spare: ไดรฟ์ที่ติดตั้งอยู่ในเครื่องและเสียบสายไว้ แต่อาจถูกตั้งสถานะให้อยู่ในโหมดประหยัดพลังงาน (Spun down / Sleep) หรือต้องอาศัยการสั่งการด้วยมือจากแอดมินผ่านซอฟต์แวร์เพื่อเปิดการทำงานเข้าสู่ระบบ ซึ่งตอบสนองช้ากว่า Hot Spare เล็กน้อยแต่ช่วยลดการสึกหรอของชิ้นส่วนกลไกและประหยัดพลังงาน
- Cold Spare: ไดรฟ์อะไหล่ที่จัดเก็บไว้ในตู้เก็บของหรือห้องสโตร์ ไม่ได้เชื่อมต่อพลังงานใด ๆ ข้อดีคือไดรฟ์ไม่เสื่อมสภาพจากการจ่ายไฟ แต่ข้อจำกัดคือต้องใช้เวลาในการเบิกอุปกรณ์ เดินทางเข้าห้องดาต้าเซ็นเตอร์ และเสียบเปลี่ยนด้วยตนเอง (Manual Intervention) ซึ่งอาจทำให้ระบบตกอยู่ในภาวะ Degradation ยาวนานเกินไป
รูปแบบการตั้งค่า Hot Spare: Dedicated, Global และ Dynamic Spare Pools
ในระดับองค์กร การจัดสรร Hot Spare ไม่ได้มีเพียงรูปแบบเดียว แต่ขึ้นอยู่กับความต้องการด้านความคุ้มค่าและความยืดหยุ่นของสถาปัตยกรรมสตอเรจ โดยทั่วไปแบ่งออกเป็น 3 รูปแบบหลัก ดังนี้:
- Dedicated Hot Spare: เป็นการกำหนดให้ไดรฟ์สำรองตัวนั้นผูกติดกับ RAID Group ชุดใดชุดหนึ่งเป็นการเฉพาะ เช่น กำหนดให้ Spare A ทำงานเฉพาะเมื่อ RAID 5 ของชุดฐานข้อมูลเสียหายเท่านั้น ข้อดีคือการันตีว่าอาร์เรย์สำคัญจะมีไดรฟ์พร้อมสำรองเสมอ แต่ข้อจำกัดคือหากกลุ่มอื่นพัง ไดรฟ์นี้จะไม่สามารถข้ามไปช่วยได้ ทำให้การใช้ทรัพยากรอาจไม่คุ้มค่า
- Global Hot Spare: ไดรฟ์สำรองจะถูกเปิดกว้างให้อาร์เรย์ใดก็ได้ในสตอเรจตัวนั้นเรียกใช้งาน เมื่อมีไดรฟ์ใดล้มเหลว ไม่ว่าจะเป็นชุดงานแอปพลิเคชันหรือชุดไฟล์เซิร์ฟเวอร์ Global Spare จะกระโดดเข้าไป Rebuild ทันที เหมาะสำหรับระบบที่มี RAID หลายชุด ช่วยประหยัดจำนวนไดรฟ์สำรองโดยรวม แต่ต้องระวังเรื่องขนาดและความเร็วของไดรฟ์ที่ต้องรองรับกลุ่มที่สเปกสูงที่สุดได้
- Dynamic / Distributed Spare: สถาปัตยกรรมสตอเรจสมัยใหม่หลายระบบ ไม่ได้กันไดรฟ์ตัวจริงไว้หนึ่งตัวว่าง ๆ แต่จะกระจายพื้นที่ว่าง (Spare Space) ข้ามทุกไดรฟ์ในระบบ เมื่อไดรฟ์ใดชำรุด ทุกไดรฟ์จะช่วยกันเขียนข้อมูลลงในพื้นที่สำรองพร้อมกัน ทำให้กระบวนการ Rebuild เสร็จสิ้นเร็วกว่าการเขียนลงดิสก์ตัวเดียวหลายเท่าตัว
หลักเกณฑ์ทางเทคนิคในการเลือกไดรฟ์มาทำหน้าที่ Hot Spare
การกำหนดไดรฟ์ที่จะนำมาตั้งค่าเป็น Hot Spare ไม่สามารถเลือกใช้อุปกรณ์ใดก็ได้ตามสะดวก แต่ต้องผ่านเกณฑ์ความเข้ากันได้ของระบบอย่างเคร่งครัด มิฉะนั้นคอนโทรลเลอร์อาจไม่อนุญาตให้ทำงาน หรือทำให้ประสิทธิภาพของระบบตกต่ำลงอย่างรุนแรง
ประการแรกคือ ขนาดความจุ (Capacity) ไดรฟ์สำรองต้องมีความจุเท่ากับหรือมากกว่าไดรฟ์ที่เล็กที่สุดในกลุ่ม RAID ที่ต้องการคุ้มครอง โดยระบบจะตัดทอนพื้นที่ส่วนเกินออกหากไดรฟ์สำรองมีขนาดใหญ่กว่า แต่จะไม่สามารถใช้ไดรฟ์ที่มีขนาดเล็กกว่าแม้เพียงไม่กี่เมกะไบต์ได้เลย
ประการที่สองคือ สื่อบันทึกข้อมูลและอินเทอร์เฟซ (Media Type & Interface) ไม่ควรผสมสื่อต่างประเภทกันในชุด Rebuild เช่น การนำ SAS HDD ความเร็วหมุน 10,000 RPM ไปสำรองให้กับ SSD แบบ Enterprise SATA จะทำให้ประสิทธิภาพของทั้งอาร์เรย์ตกลงอย่างมาก หรือในบางคอนโทรลเลอร์จะปฏิเสธการจับคู่ข้ามเทคโนโลยีทันที รวมถึงขนาดเซกเตอร์ เช่น 512n, 512e และ 4Kn ซึ่งต้องตรวจยืนยันความเข้ากันได้ของรูปแบบบล็อกข้อมูลเสมอ
ประการที่สามคือ อายุการผลิตและการสึกหรอ โดยเฉพาะในกรณีของ SSD ซึ่งมีค่าการเขียนข้อมูลสะสม (Endurance / TBW) ไดรฟ์สำรองต้องมั่นใจว่าไม่มีอัตราการสึกหรอสูงเกินไป เพื่อให้พร้อมรองรับภาระงานเขียนมหาศาลตลอดการ Rebuild ข้อมูลทั้งลูก
ตัวอย่างสถานการณ์สมมุติ: การทำงานของระบบเมื่อเกิดไดรฟ์ชำรุดและการตัดสินใจทางไอที
เพื่อความเข้าใจที่ชัดเจน ขอยกตัวอย่างสถานการณ์สมมุติในห้องเซิร์ฟเวอร์ของบริษัทจำลองแห่งหนึ่ง ซึ่งใช้งานสตอเรจควบคุมฐานข้อมูลด้วยโครงสร้าง RAID 6 จำนวน 8 ไดรฟ์ (ไดรฟ์ข้อมูล 6 ตัว และ Parity 2 ตัว) พร้อมทั้งติดตั้ง Global Hot Spare สแตนด์บายไว้อีก 1 ไดรฟ์
ในวันหยุดสุดสัปดาห์ เวลา 02:00 น. ไดรฟ์ตัวที่ 4 ในอาร์เรย์เกิดปัญหาเชิงกลอย่างรุนแรงและหยุดทำงาน คอนโทรลเลอร์แจ้งเตือนสถานะ Drive Failed และในทันทีนั้น ระบบได้เรียกใช้ Global Hot Spare เข้ามาแทนที่ และเริ่มกระบวนการ Rebuild ข้อมูลโดยอัตโนมัติจากค่า Parity ที่กระจายอยู่ในไดรฟ์ตัวอื่น
เช้าวันจันทร์ เมื่อผู้ดูแลระบบเข้ามาตรวจสอบ พบว่าข้อมูล Rebuild เสร็จสิ้นสมบูรณ์แล้ว ระบบยังคงให้บริการได้ตามปกติโดยไม่มีข้อมูลสูญหาย สิ่งที่ทีมไอทีต้องตัดสินใจและจัดการต่อทันทีคือ:
1. ทำการดึงไดรฟ์ที่ชำรุดตัวเดิมออกจากสล็อต เพื่อเตรียมส่งคืนหรือทำลาย
2. เสียบไดรฟ์อะไหล่ตัวใหม่เข้าไปในเบย์ที่ว่าง เพื่อตั้งค่ากลับมาเป็น Hot Spare ตัวใหม่สำหรับคุ้มครองระบบต่อไปในอนาคต
3. จัดการไดรฟ์ที่พังแล้วอย่างรัดกุม เพราะแม้ไดรฟ์จะใช้งานในระบบไม่ได้ แต่จานแม่เหล็กหรือชิปหน่วยความจำยังคงมีชิ้นส่วนข้อมูลสำคัญตกค้างอยู่
ความเสี่ยงเรื่องข้อมูลรั่วไหลเมื่อไดรฟ์ชำรุดหลุดออกจากสตอเรจ
ข้อผิดพลาดที่พบบ่อยที่สุดในองค์กรคือการเข้าใจผิดว่า ไดรฟ์ที่คอนโทรลเลอร์ฟ้องว่า "Failed" หรือ "Offline" นั้นแปลว่าข้อมูลข้างในถูกทำลายไปแล้ว ทั้งที่ในความเป็นจริง ไดรฟ์เหล่านั้นมักพังเพียงบางส่วน เช่น แผงวงจรควบคุมขัดข้อง มอเตอร์หมุนติดขัด หรือมี Bad Sector ในส่วนพื้นที่บูตระบบ แต่บล็อกข้อมูลบนจานบันทึกหรือชิป NAND Flash ส่วนใหญ่ยังคงอยู่ครบถ้วนสมบูรณ์
หากไดรฟ์ที่ถอดเปลี่ยนออกมาถูกนำไปกองทิ้งไว้ในตู้โดยไม่มีการควบคุม หรือส่งคืนเคลมไปยังผู้ขาย (RMA) โดยไม่มีข้อตกลงเรื่องการรักษาความปลอดภัยของข้อมูล บุคคลภายนอกที่มีเครื่องมือเฉพาะทางด้าน Data Recovery ย่อมสามารถเข้าถึงข้อมูลฐานข้อมูล บัญชี หรือข้อมูลส่วนบุคคลของลูกค้าได้โดยง่าย
ดังนั้น องค์กรที่มีมาตรฐานความปลอดภัยสารสนเทศ เช่น ISO 27001 หรือต้องปฏิบัติตามกฎหมายคุ้มครองข้อมูลส่วนบุคคล จึงต้องมีนโยบายจัดการกับไดรฟ์ที่ปลดระวางจากการ Rebuild อย่างเด็ดขาด ไม่ว่าจะเป็นการใช้ซอฟต์แวร์ลบข้อมูลหากไดรฟ์ยังตอบสนองคำสั่ง หรือการส่งต่อเพื่อเข้ากระบวนการทำลายข้อมูลฮาร์ดดิสก์ทางกายภาพเมื่อไดรฟ์ไม่สามารถอ่านเขียนได้แล้ว
ขั้นตอนและเช็กลิสต์การปลดระวางและส่งมอบไดรฟ์ชำรุดเพื่อความปลอดภัย
เมื่อต้องถอดไดรฟ์ที่เสียหายออกจากสตอเรจหลังจาก Hot Spare เข้าไปแทนที่ แนะนำให้ฝ่ายไอทีปฏิบัติตามเช็กลิสต์ที่เป็นมาตรฐานดังต่อไปนี้:
- การระบุและยืนยันตำแหน่ง: ตรวจสอบไฟสถานะ LED (Fault / Locate) ที่หน้าถาดฮาร์ดดิสก์ให้ตรงกับรหัส Slot ID ในโปรแกรมบริหารจัดการ เพื่อป้องกันการดึงไดรฟ์ผิดตัว ซึ่งอาจทำให้อาร์เรย์ล่มทั้งชุด
- บันทึกข้อมูลประจำตัวอุปกรณ์: ทำการจดบันทึก Serial Number (S/N), หมายเลข Model, ขนาดความจุ และวันที่ปลดระวาง ลงในระบบบริหารสินทรัพย์ (Asset Management) ทันที
- การคัดแยกประเภทสื่อบันทึก: แยกไดรฟ์จานแม่เหล็ก (HDD) ออกจากไดรฟ์แบบชิป (SSD / M.2) เนื่องจากกระบวนการทำลายทางกายภาพใช้เครื่องมือและระยะการบดย่อยที่ต่างกัน
- ตรวจสอบเงื่อนไขการเคลมอุปกรณ์: หากเป็นอุปกรณ์เช่าหรืออยู่ในสัญญาประกันที่ต้องส่งคืนซาก (Disk Retention Service) ต้องยืนยันกับคู่สัญญาว่าสามารถเจาะทำลายหรือลบข้อมูลก่อนส่งมอบได้หรือไม่
ในรอบการปรับปรุงโครงสร้างพื้นฐานสตอเรจ เมื่อมีการปลดระวางเซิร์ฟเวอร์เก่าหรืออัปเกรดความเร็วของระบบแคชและพื้นที่บูต ไดรฟ์ส่วนเกินที่ยังสภาพดีและผ่านการล้างข้อมูลถาวรแล้วอาจส่งต่อเพื่อหมุนเวียนมูลค่า เช่น การใช้ช่องทางที่รับซื้อ ssd m.2 สำหรับสต็อกส่วนเกินที่ไม่ได้ใช้งานแล้ว ส่วนไดรฟ์ที่ชำรุดเสียหายหรือไม่ผ่านเกณฑ์ความปลอดภัยจะต้องถูกคัดแยกออกเพื่อส่งเข้ากระบวนการทำลายสื่อบันทึกข้อมูลอย่างเคร่งครัด
- การจัดเก็บในพื้นที่ปลอดภัย: เก็บไดรฟ์ที่รอการทำลายไว้ในตู้ล็อกที่มีการจำกัดสิทธิ์การเข้าถึง เพื่อป้องกันการสูญหายหรือการหยิบสลับไปใช้งานผิดวัตถุประสงค์
การเลือกวิธีทำลายไดรฟ์ที่ชำรุด: ลบข้อมูลถาวร vs การทำลายทางกายภาพ
ในการจัดการข้อมูลตกค้างบนไดรฟ์สตอเรจที่ชำรุด ผู้รับผิดชอบต้องประเมินสถานะการทำงานของสื่อเพื่อเลือกแนวทางที่ถูกต้อง:
- การลบข้อมูลด้วยซอฟต์แวร์ (Data Sanitization / Overwriting): เหมาะสำหรับไดรฟ์ที่ยังคงตอบสนองต่อคำสั่งอ่านเขียนและระบบคอมพิวเตอร์ยังมองเห็นไดรฟ์ วิธีนี้จะเขียนข้อมูลทับทุกเซกเตอร์ตามมาตรฐานสากล เช่น NIST SP 800-88 แต่ข้อจำกัดคือ ไม่สามารถใช้กับไดรฟ์ที่มอเตอร์ล็อก หัวอ่านพัง หรือชิปควบคุมไหม้จนบอร์ดไม่ตอบสนองได้
- การล้างสนามแม่เหล็ก (Degaussing): เหมาะสำหรับฮาร์ดดิสก์แบบจานแม่เหล็ก (HDD) และเทปแม่เหล็ก โดยใช้คลื่นแม่เหล็กกำลังสูงสลายขั้วแม่เหล็กบนแผ่น Platter ทำให้ข้อมูลหายไปทันทีและแผ่นไม่สามารถนำกลับมาใช้ใหม่ได้ ข้อจำกัดคือวิธีนี้ไม่สามารถใช้กับ SSD หรือชิปแฟลชได้เลย เพราะชิปเก็บข้อมูลด้วยประจุไฟฟ้าไม่ใช่สนามแม่เหล็ก
- การทำลายทางกายภาพ (Physical Destruction): ได้แก่ การใช้เครื่องเจาะทำลายทะลุแผ่นจานบันทึก (Hard Drive Punching / Crushing) หรือการนำเข้าเครื่องย่อยโลหะละเอียด (Shredding) ซึ่งวิธีนี้เป็นวิธีสากลที่สามารถใช้ได้กับทั้ง HDD และ SSD ชิ้นส่วนจะถูกตัด บิดงอ หรือบดละเอียดจนโครงสร้างเซลล์เก็บข้อมูลพังทลายอย่างถาวร ไม่สามารถประกอบกลับมาอ่านข้อมูลได้อีก เหมาะที่สุดสำหรับไดรฟ์ที่เสียหายจนไม่สามารถลบด้วยซอฟต์แวร์ได้
คำถามที่พบบ่อยเกี่ยวกับ Hot Spare และการจัดการสื่อบันทึกข้อมูล (FAQ)
ระบบ RAID ชนิดใดบ้างที่ไม่รองรับการใช้งาน Hot Spare?
RAID 0 ไม่สามารถใช้งาน Hot Spare เพื่อ Rebuild ข้อมูลได้เลย เนื่องจากไม่มีการเก็บข้อมูล Parity หรือการคัดลอกข้อมูลซ้ำ (Mirroring) หากไดรฟ์ใดชำรุด ข้อมูลทั้งหมดจะสูญหายทันที ส่วน RAID อื่น ๆ เช่น RAID 1, 5, 6, 10, 50, 60 รองรับการตั้งค่า Hot Spare ได้ตามการสนับสนุนของคอนโทรลเลอร์
หากไดรฟ์ติดระบบเข้ารหัสข้อมูล (Encryption / SED) อยู่แล้ว ยังจำเป็นต้องทำลายทางกายภาพหรือไม่?
แม้ไดรฟ์จะมีการเข้ารหัสในระดับฮาร์ดแวร์ แต่ตามมาตรฐานความปลอดภัยสารสนเทศขององค์กรส่วนใหญ่ การทำลายทางกายภาพหรือการทำ Cryptographic Erase ร่วมกับการบดทำลายยังคงเป็นข้อบังคับหลัก เพราะไม่สามารถรับประกันได้ว่ากุญแจถอดรหัสจะไม่มีวันรั่วไหลในอนาคต
ระหว่างกระบวนการ Rebuild ข้อมูลไปยัง Hot Spare ระบบสตอเรจจะทำงานช้าลงหรือไม่?
ระบบจะมีการแบ่งทรัพยากรการอ่านเขียนของไดรฟ์ที่เหลือเพื่อคำนวณและเขียนข้อมูลลง Hot Spare ส่งผลให้ความเร็วในการตอบสนอง (I/O Performance) ของสตอเรจลดลงชั่วคราว ผู้ดูแลระบบสามารถปรับค่า Rebuild Priority ในคอนโทรลเลอร์เพื่อรักษาสมดุลระหว่างความเร็วของงานกับเวลาในการกู้คืนระบบได้
การส่งทำลายฮาร์ดดิสก์นอกสถานที่ (On-site Destruction) มีประโยชน์อย่างไรเมื่อเทียบกับการส่งไปทำลายที่ศูนย์บริการ?
การทำลายแบบ On-site ช่วยให้ไดรฟ์ที่มีข้อมูลสำคัญไม่ต้องถูกขนส่งออกนอกรั้วองค์กร ลดความเสี่ยงระหว่างการเดินทาง และฝ่ายไอทีหรือผู้ตรวจสอบสามารถยืนยันกระบวนการทำลายต่อหน้าได้แบบเรียลไทม์ พร้อมตรวจสอบ Serial Number ของทุกชิ้นได้อย่างแม่นยำ
สิ่งที่ควรเตรียมเมื่อต้องการขอรับบริการทำลายฮาร์ดดิสก์และสื่อสตอเรจ
สำหรับองค์กรที่ต้องการปลดระวางไดรฟ์ที่ชำรุดจากการใช้งานในเซิร์ฟเวอร์หรือสตอเรจอย่างเป็นทางการ การประสานงานกับผู้ให้บริการทำลายข้อมูลจะมีความรวดเร็วและถูกต้องที่สุด เมื่อมีการเตรียมข้อมูลล่วงหน้าดังต่อไปนี้:
- รายการตรวจนับอุปกรณ์ (Asset List): จัดทำตารางสรุปจำนวนสื่อบันทึกทั้งหมด พร้อมระบุ Serial Number ของแต่ละไดรฟ์ เพื่อใช้ในการตรวจนับและออกใบรับรองการทำลาย (Certificate of Destruction)
- ชนิดและฟอร์มแฟกเตอร์ของอุปกรณ์: ระบุว่าเป็น 3.5" HDD, 2.5" HDD, SAS, Enterprise SATA หรือเป็น SSD ชนิดชิป NAND เพื่อให้ผู้ให้บริการเตรียมเครื่องจักรและใบมีดย่อยที่เหมาะสม
- รูปแบบการทำลายที่ต้องการ: เลือกระหว่างการเจาะกดทำลาย (Crushing) หรือการบดย่อยละเอียด (Shredding) ตามระดับข้อกำหนดนโยบายความปลอดภัยขององค์กร
- สถานที่ดำเนินงาน: ระบุความประสงค์ว่าต้องการให้เข้าบริการบดทำลายถึงสถานที่ของท่าน (On-site) หรือต้องการบริการขนส่งแบบปิดมิดชิดเพื่อนำไปทำลายที่โรงงานกำจัด
- ความต้องการด้านหลักฐาน: แจ้งล่วงหน้าหากต้องการบันทึกภาพนิ่ง บันทึกวิดีโอขณะทำลายทุกชิ้น หรือต้องการให้มีเจ้าหน้าที่ความปลอดภัยร่วมสังเกตการณ์ตลอดกระบวนการ